Mothership
지식 검색
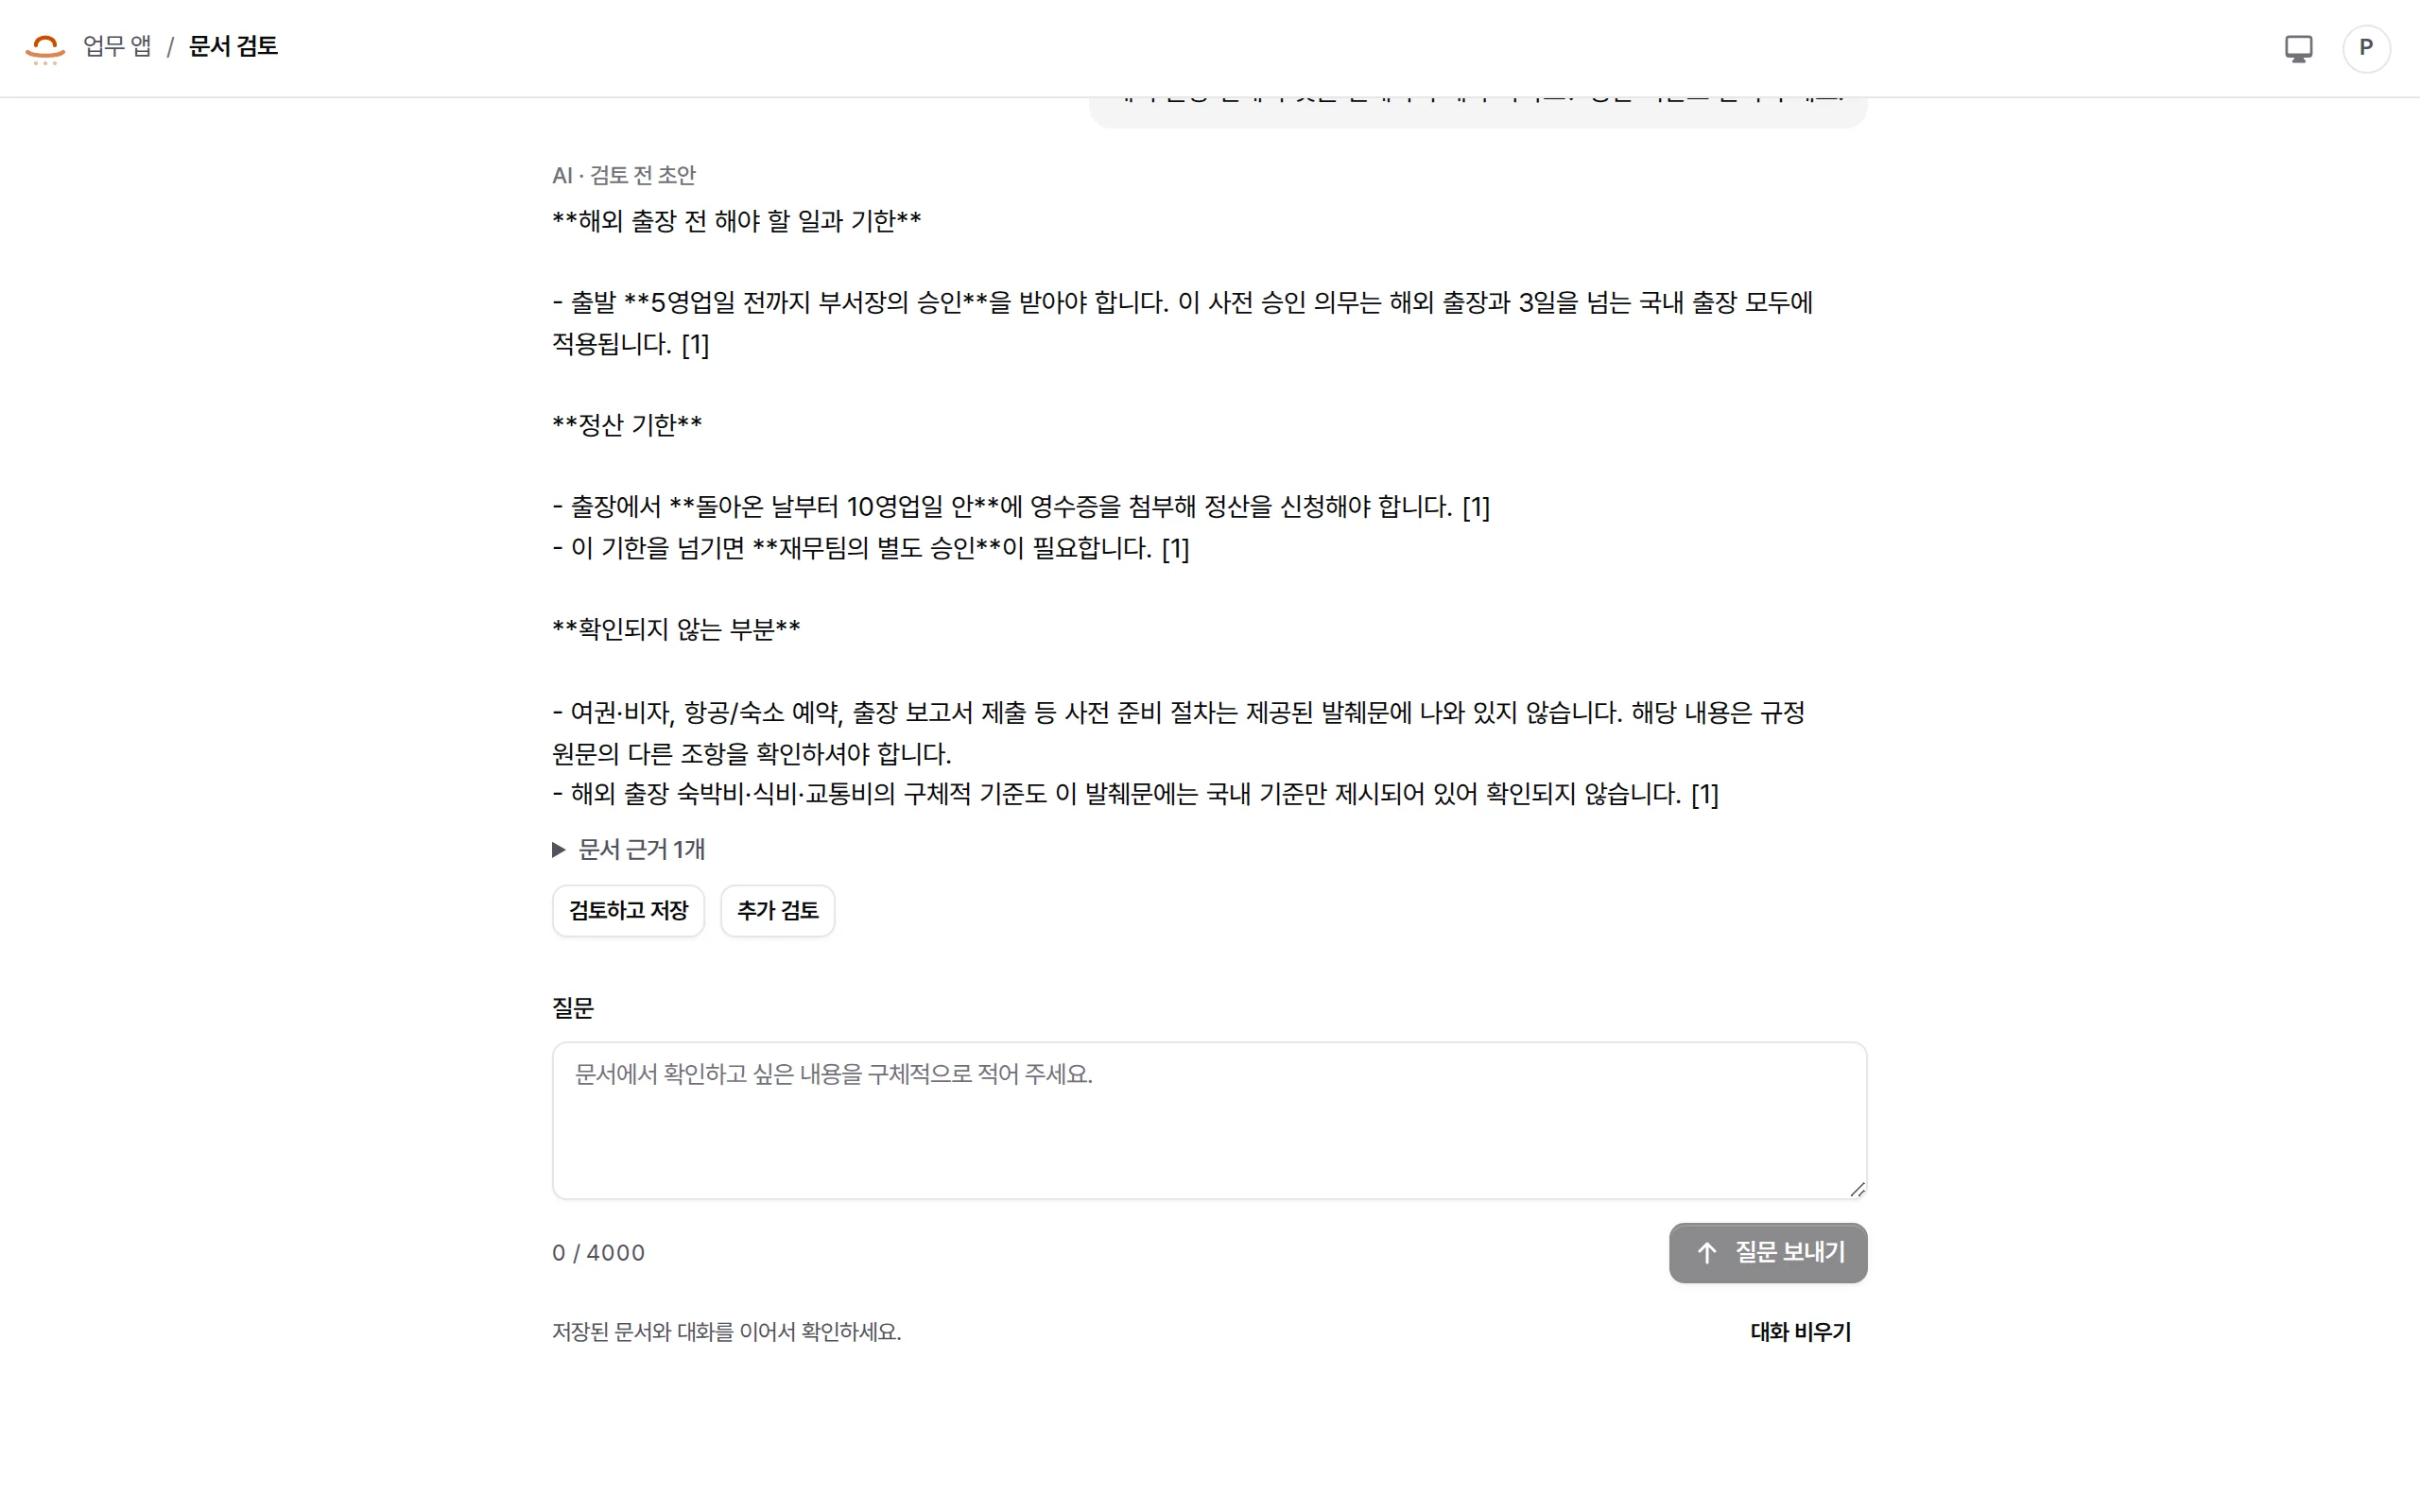
앱이 올린 문서를 비공개로 추출·색인하고, 고른 문서 안에서 찾아 인용과 함께 답해요. 출처 권한은 읽을 때마다 다시 확인해요.
문서의 수명
- 올리기와 접수 — 앱이 파일을 올리고 수집을 접수해요(SDK 1.1부터 기본은 대기열). 게이트웨이가 작업을 남기고 바로 답해요.
- 추출과 색인 — 지식 워커가 텍스트를 뽑고(PDF, Office, 이미지 OCR, 텍스트) 색인해요. 임베딩 모델이 있으면 벡터도 만들어요.
- 검색과 인용 — 앱이 컬렉션과 문서를 골라 찾아요. 결과에는 인용할 수 있는 구간이 있어요.
- 지우기 — 문서를 지우면 찾을 수 있는 내용과 원본 파일이 함께 지워져요.
ts
const file = await ctx.files.upload(selectedFile);
const queued = await ctx.knowledge.ingest({
  collectionId: "review-documents", fileId: file.fileId,
  title: file.name, scope: "user_private",
}, { idempotencyKey: `ingest:${file.fileId}` });
await ctx.jobs.wait(queued.jobId);
const results = await ctx.knowledge.search({
  collections: ["review-documents"], documentIds: [queued.documentId],
  query: "승인이 필요한 일은?", topK: 6,
});
공유 범위
| 범위 | 볼 수 있는 사람 |
|---|---|
user_private(기본) |
올린 사람 |
space_shared |
호스트가 고른 팀 공간의 구성원(앱이 보낸 공간 ID는 쓰지 않아요) |
org_shared |
같은 회사, 같은 앱, 같은 환경의 구성원 |
원본 파일은 추출한 텍스트를 공유해도 비공개로 남아요. 목록, 검색, 인용, 내려받기마다 컬렉션 선언과 지금의 구성원 자격을 다시 확인해요.
찾는 방식과 한계
- PostgreSQL: GIN 전문 색인으로 후보를 고르고, 임베딩이 설정돼 있으면 정해진 수의 후보를 의미로 다시 정렬해요. 무한정 벡터를 훑거나 ANN 벡터 DB를 쓰지 않아요.
- SQLite: 정해진 범위의 문자열 검색이에요. 개발용이에요.
- 검색 결과는 어떤 방식으로 찾았는지와 잘렸는지를 알려 줘요. 임베딩 공급자나 모델을 바꾸면 다시 색인해야 옛 벡터가 의미 정렬에 들어가요.
- 문서 처리는 따로 된 프로세스에서 CPU·메모리·쪽수·픽셀·출력 크기·시간 한도로 돌아요. 기본은 입력 25 MiB, 25쪽, 120초예요. 암호가 걸린 PDF는 풀고 올려요.
워커
make dev(개발)와 운영 Compose의 workers가 지식 워커를 함께 돌려요. 따로 돌리려면:
bash
.venv/bin/python backend/manage.py knowledge_worker
.venv/bin/python backend/manage.py document_worker   # PDF·OCR 변환
문서 검색 · RAG · 지식 · 임베딩 · 의미 검색